こんにちは、ニケです。
リアルタイム動画生成を使って、YouTubeのコメントに応じて話し、動くAITuberを作りました。
コメントから返答の文章と動作を考え、合成音声と一緒に動画生成APIへ送ることで、AIニケちゃんが映像の中で応答できるようにしています。
キャラクターの開始画像を用意し、その続きの映像を生成していく構成です。
例えば「手を振って」といったコメントを、セリフだけでなく、映像の動きにも反映するように指示できます。
実際の配信はこちらです。
まず、映像生成に使っているH3 Max Directorの仕組みを説明し、その後にAITuberとしてどう組み合わせているかを紹介します。
H3 Max Directorは、映像を生成しながら指示を追加できる
使用しているのは、falで提供されている H3 Max Director です。
 fal.ai
接続を維持したまま映像を受け取り、途中で新しい演出指示を送れる点に特徴があります。
開始時に場面を設定し、その後は「歩いて」「手を振って」のような指示で、これから生成する内容を変えていきます。
映像と音声の受信に使うのは、ブラウザで音声や映像をリアルタイムにやり取りする技術、WebRTCです。
演出指示は、同じ接続のデータチャネルを通して送ります。
続きの映像はfal側で生成される
開始時には、最初の画像のURLや、場面・動作を指定するプロンプトを渡します。
公式説明によると、直前の区間の映像や過去のプロンプトを引き継ぎながら、続きの区間を生成する仕組みです。
区間の重なりを処理することで、連続したストリームとして配信できます。
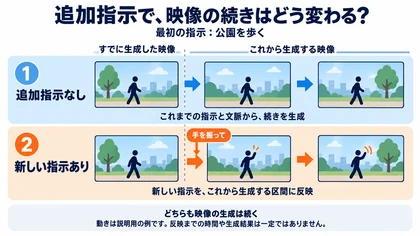
追加の指示を送らなくても、セッションが動いている間は映像の生成が続きます。
そのときに続きを作る手がかりとなるのが、すでに渡した指示と、それまでの映像・プロンプトの文脈です。
具体的にどう動き続けるかは生成結果次第で、同じ動作や外見がずっと保たれる保証はありません。
なお、課金の対象は生成された動画の長さなので、指示を送らずに見ている間も費用はかかります。
新しい指示を追加した場合、反映先は後続の生成区間です。
そのため、リアルタイムといっても、指示した瞬間に画面の動きが変わるわけではありません。
途中の更新では、動作の指示に加えて音声ファイルのURLも送信可能です。
外部で合成した声を実際に再生する音声として渡すと、その音声を条件に映像が生成されます。
詳細は上記のDirector紹介ページと、公式API仕様で確認できます。
このAPIを使って、コメントに反応するAITuberを動かす
今回作ったのは、ローカルのブラウザで動くアプリです。
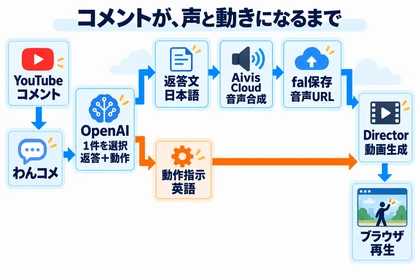
Directorには映像生成を担当させ、コメントの取得、返答の判断、音声合成は、それぞれ別の処理としてつないでいます。
| 担当 | 使用しているもの |
|---|---|
| YouTubeコメントの取得 | わんコメ+連携プラグイン |
| コメント選択・返答・動作の作成 | OpenAI |
| 返答文の音声合成 | Aivis Cloud |
| 音声と動作指示からの映像生成 | falのH3 Max Director |
| 再生・コメント表示・録画 | ローカルのブラウザアプリ |
コメントを受け取り、返答と動作を一緒に考える
YouTubeへの接続とコメント取得はわんコメが担当し、専用の連携プラグインからアプリへコメントを渡します。
受け取ったコメントはすべて順番に読み上げるのではなく、最新の数件を応答候補としてAIに渡し、そこから選ばれた1件に対する返信を生成する設計です。
返答AIモデルには gpt-5.6-luna を使用していました。
返答内容の正確さよりも、応答の速度と安定性を優先した結果です。
1回のリクエストで、返答文(日本語)と動作指示(英語)を同時に、決められたJSON形式で受け取ります。
例えば「笑顔で手を振って」という入力なら、短い挨拶の文章と、笑顔で手を振る動作の指示を同じ処理で考える、という形です。
合成音声と動作指示をDirectorへ送る
返答文ができたら、Aivis Cloudで音声を合成し、MP3を全量受け取ってからfalのストレージへアップロードします。
Directorへ渡すのは、その音声のURLと動作指示です。
何を話すかはOpenAI LLM、どの声で読むかはAivis Cloud、どんな映像にするかはfalのDirectorが担当します。
AIニケちゃんの外見は、開始時に渡す画像や場面の指示だけに任せるわけではありません。
応答時の動画プロンプトにも外見の指示を含めることで、キャラクターを維持しながら今回の動作を行うようにしています。
返ってきたWebRTCの映像と音声は、そのままブラウザで再生します。
会話と場面の状態を、次の指示にも渡す
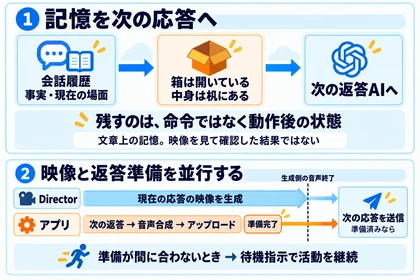
次のコメントに応答するときは、過去の会話に加え、会話上の事実と現在の場面をまとめた短い記憶を返答AIへ渡します。
保持する内容は、例えば「誰から何をもらったか」と「今どこにいて、何をしているか」。
こうした情報を、会話ログとは別にまとめています。
場面の記憶として残すのは、過去の動作命令ではなく、動作後の状態です。
例えば、「箱を開けて」という命令を残すのではなく、「箱は開いていて、中身が机にある」という状態を次の応答へ渡します。
動画側の指示にも動作前後の状態を含めるのは、前の行動を踏まえて続きを生成してもらうためです。
なお、アプリが保持しているのは文章上の状態で、映像を見て成功を判定しているわけではありません。
そのため、計画した内容と実際の映像にずれが出る可能性はあります。
返答の準備と、映像の継続を重ねる
現在の応答をDirectorへ送った後、新しい候補があれば次の1件の返答・音声合成・アップロードを先に進めます。
Directorから現在の応答の音声終了通知を受け取った後、準備済みの次の応答を送ります。
これは生成側での終了通知で、ブラウザでの再生完了を確認するものではありません。
次の返答がまだ用意できていない場合は、現在の場所や活動に合った待機指示を送ります。
コメントへの返答を準備している間も、映像側では活動を続ける方針です。
このように、Directorの連続映像生成へ、コメント選択・返答・音声合成・状態管理を組み合わせて、視聴者のコメントに反応するAITuberを構成しています。
実際の配信で見えた課題
この構成で4回配信してみると、コメントに応じて映像が変わる面白さがある一方、大きな場面変更に映像が追従せず、発話と食い違うことがありました。
外見をプロンプトで指定していても、フレームアウト後の顔立ちや、長時間生成したときの画風の変化までは防ぎきれません。
私の配信では、長時間続けると画面が暗く、よどんでいく印象もあり、気になった時点で新しいセッションからやり直していました。
これらは今回の運用での観測で、モデルとプロンプトそれぞれの影響を切り分けられたわけではありません。
配信の具体例やYouTubeでの反応、今後については、4回配信した振り返りにまとめています。
関連リンク
AIツールやAIキャラクターの開発について、Xでも発信しています。
 x.com